揭示 LLM 瓶頸:可觀測性、OTEL 和成本控制
業務簡介:OpenTelemetry、Prometheus/Grafana、Langfuse — 優點、缺點、成本以及可削減代理支出的使用指標
 Balinder Walia2026年9月4日1 min read
Workstation業務簡介:透過可觀察性發現 LLM 和代理瓶頸 — OpenTelemetry、Prometheus/Grafana/Thanos 和 LLM 平臺(例如 Langfuse) — 這樣您就可以削減成本、收緊 SLO 並向代理提供證據。深入探討:長篇技術文章(OTEL、FinOps、代理預算)。相關:渦輪增壓 LLMs·企業人工智慧實驗室。
底線。大多數“慢人工智慧”問題並不是神秘的模型故障——它們缺少歸因。儀器代理與 OpenTelemetry 一起執行,對輸出進行評分,使用租戶/模型/路線/令牌/成本標記每個呼叫,並執行預算。執行此操作的團隊通常會在第一個測量週期內發現 20-50% 的浪費在於重試、過大的模型和未快取的提示。
為什麼瓶頸會在沒有遙測的情況下隱藏
LLM 代理鏈提示、工具、RAG 檢索和重試。跨躍點的延遲和花費複合。 如果沒有跨度和指標,您就無法判斷瓶頸是模型、向量儲存、不穩定的工具還是無限的自除錯迴圈。然後,業務利益相關者過度購買 GPU 或 API 配額,而產品質量卻保持不變。
Workstation 對 AI 資產的立場:像對待任何其他生產服務一樣對待代理管道 —可觀察性首先,然後最佳化服務(請參閱PagedAttention / vLLM),然後按紀律進行推廣(Ring Promoter)。
物有所值的可觀察性堆疊
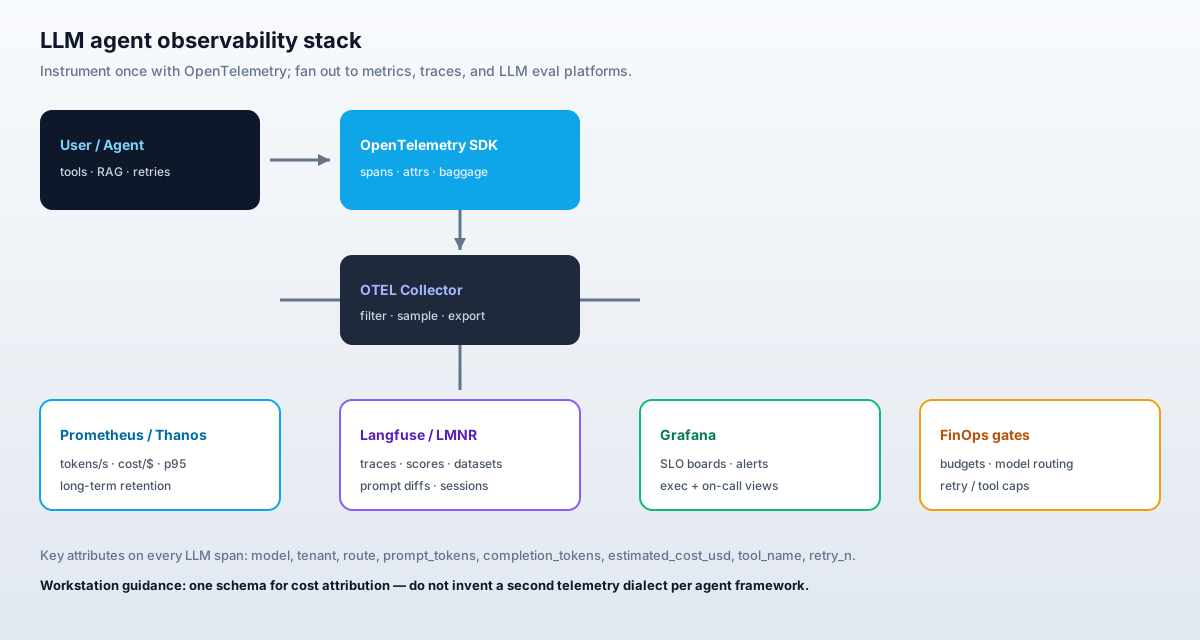
- OpenTelemetry (OTEL)— 用於跟蹤、指標和(如果有用)日誌的一個儀器層。匯出至收集器;扇出到後端。
- Prometheus + Grafana (+ Thanos)— 黃金訊號:請求率、錯誤率、延遲、代幣吞吐量、估計/請求美元、GPU 利用率。 Thanos(或同等機構)保留 FinOps 稽核的長期指標。
- LLM 可觀測平臺(例如Langfuse、LMNR) — 會話/跟蹤 UI、提示版本、人工和跟蹤版本自動評分、迴歸資料集。
這種方法的優點和缺點
| 尺寸 | 優點 | 缺點/權衡 |
|---|---|---|
| 成本控制 | 將支出歸因於租戶、功能、型號和代理步驟;消除浪費的重試。 | 儀器的工程時間;如果保留是幼稚的,則痕跡的儲存成本。 |
| 質量 | 分數 + 資料集在客戶之前捕獲即時迴歸。 | 自動評分可能會很吵;關鍵路徑仍然需要人類。 |
| 操作 | 與其他微服務相同的 OTEL/Prometheus 技能集。 | LLM 特定 UI(Langfuse 等)新增另一個要執行或購買的產品。 |
| 合規性 | 審計誰呼叫了哪個型號,哪個提示版本。 | 提示/PII 保留策略必須預先設計。 |
| 實現價值的速度 | 如果您已經執行 Grafana,幾天後就會出現第一個儀表板。 | 跨多代理圖的完整成本歸因需要更長的時間。 |
成本:您花費的費用與您節省的費用
儀器成本(典型的中型代理平臺):
- 1-2 工程師周採用 OTEL 跨度約定 + 出口接線。
- 收集器 + 指標保留:一旦調整取樣,通常小於每月 LLM API/GPU 支出的 5-10%。
- 可選 SaaS LLM 可觀測性:按事件/跟蹤定價 — 將其預算為模型支出的百分比,而不是事後的想法。
節省槓桿(推動使用指標):
- 每個成功任務的令牌— 不是每個原始呼叫的令牌。限制工具迴圈和自除錯輪次。
- 每成功任務的成本— 路由廉價模型進行分類/路由;為艱難的步驟保留前沿模型。
- 快取命中率— 提示/字首快取安全;衡量正確性,而不僅僅是延遲。
- 重試率&死信率— 脆弱的工具偽裝成“模型質量”問題。
- p95 TTFT 和端到端延遲— 在削減支出的同時保護使用者體驗。
經驗法則。如果您無法回答“該代理上週按客戶分步花費了多少費用?”你還沒有準備好擴充套件使用——你已經準備好給財務帶來驚喜了。
評分:手動與自動
| 方法 | 何時使用 | 商務筆記 |
|---|---|---|
| 手動評分 | 黃金套裝、規範答案、品牌敏感副本。 | 價格昂貴,但具有自動判斷功能。 |
| 自動評分 | 大容量回歸、LLM 作為判斷、標題檢查。 | 規模便宜;每月針對人類進行校準。 |
遷移手冊(從小處開始)
- 儀器一條具有 OTEL + 令牌/成本屬性的端到端生產代理路徑。
- 運送 Grafana 板,以衡量速率/錯誤/延遲/成本/成功。
- 新增 Langfuse(或同等版本)以獲取該路徑上的提示版本和分數。
- 強制實施硬上限:最大令牌數、最大工具呼叫數、每個會話的最大重試次數。
- 僅在第一條路徑顯示測量的成本或延遲優勢後才擴充套件到下一個代理。
觀察:為什麼可觀察性對於 AI 系統很重要
關於可觀察性文化的上下文討論 — 不是 Workstation 產品演示。與OpenTelemetry 文件和Workstation 技術文章配對。
讀取下一個
- 長文— OTEL 跨架構、收集器、成本公式、代理上限、Langfuse/LMNR 註釋。
- Turbocharging LLMs— 您可以看到服務端瓶頸。
- 本地代理·企業人工智慧實驗室·聯絡方式 Workstation
由Workstation釋出。參考文獻:langfuse/langfuse·lmnr-ai/lmnr·OpenTelemetry。