生產中的 MySQL 高可用性:InnoDB 叢集、組複製和 Kubernetes Operator
有關 InnoDB 叢集、組複製、Kubernetes 的 MySQL Operator、Percona XtraDB 叢集、多雲策略以及使用 Longhorn 儲存的裸機 k3s/Rancher 部署的生產工程師指南
 Balinder Walia2026年4月12日15 min read
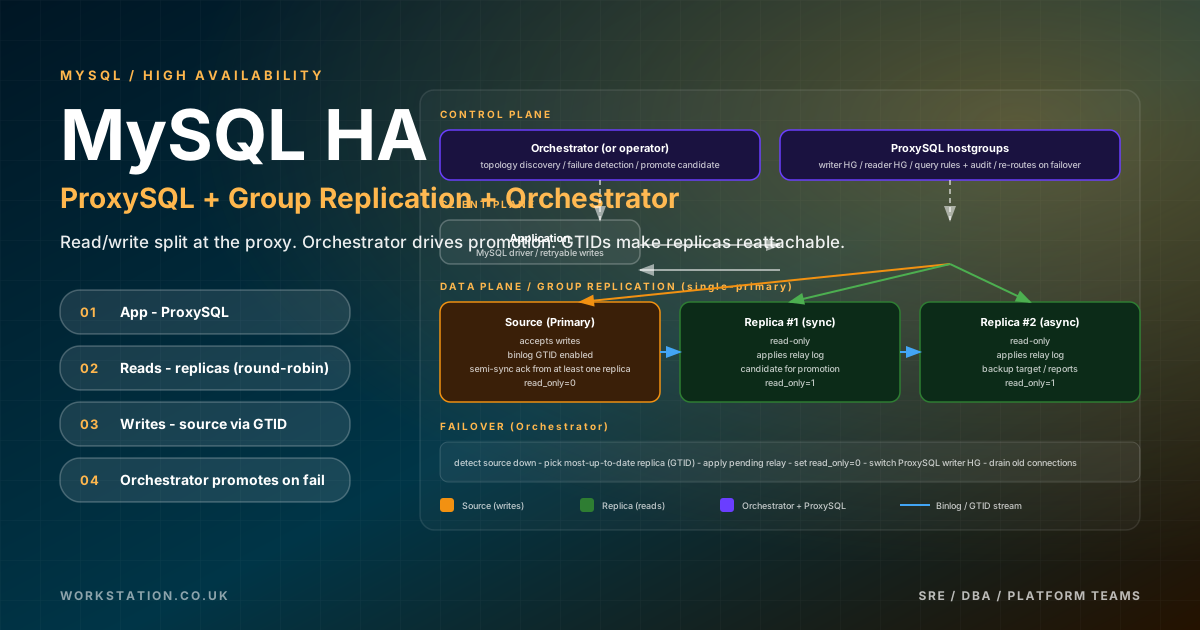
在生產中執行 MySQL 對於大多數工程團隊來說都是熟悉的領域。以真正的高可用性執行它——節點故障、網路分割槽或整個可用區變暗不會導致停機或資料丟失——需要精心設計的架構。本指南詳細介紹了該架構的每一層:從 MySQL 本身內部的複製原語,到自動化生命週期管理的 Kubernetes 運算子,到每個主要雲提供商的託管和自我管理選項,再到 Rancher 管理的裸機 k3s 叢集。
在本文結束時,您將擁有在生產中選擇和操作 MySQL HA 的完整心智模型,以及可適應您自己的環境的具體配置示例。
MySQL InnoDB 叢集架構
InnoDB Cluster 是 Oracle 針對 MySQL 的整合高可用性解決方案。它結合了三個元件:用於資料同步的 MySQL 組複製、用於叢集管理的 MySQL Shell 以及用於透明連線路由和自動故障轉移的 MySQL 路由器。它們一起形成一個自我修復叢集,無需人工干預即可容忍節點故障。
架構簡潔而優雅。應用程式連線到 MySQL 路由器,該路由器透過查詢 InnoDB 叢集後設資料架構來保持對叢集拓撲的瞭解。當主伺服器發生故障時,組複製會從剩餘的輔助伺服器中選擇一個新的主伺服器,MySQL 路由器會自動將寫入流量重定向到新的主伺服器(通常在幾秒鐘內)。讀取流量可以分佈在所有輔助節點上,以實現水平讀取擴充套件。
組複製基礎知識
MySQL 組複製是 InnoDB Cluster 的基礎。它使用基於 Paxos 的共識協議來確保在主節點上提交的每個事務在被確認之前都被複制到大多數節點。 這提供了虛擬同步複製— 保證提交的資料在提交時至少存在於大多數叢集成員上。
組複製以兩種模式執行:
- 單主模式— 一個節點接受寫入(主節點);所有其他都是隻讀輔助物件。這是推薦的預設模式。它完全避免了寫衝突,因為只有一個節點可以生成事務。
- 多主模式— 所有節點同時接受寫入。這為跨不同表或鍵空間進行乾淨分割槽的工作負載提供了更高的寫入吞吐量,但是當併發事務修改相同的行時,它會引入認證衝突的可能性。衝突的事務會在一個節點上回滾。僅當您的應用程式設計為處理認證失敗和重試邏輯時,才使用多主。
使用 MySQL Shell 設定 InnoDB 叢集
MySQL Shell 提供 AdminAPI,這是一組自動化整個叢集生命週期的功能。以下是 3 節點叢集的完整設定順序。
# Step 1: Prepare each MySQL instance (run on all 3 nodes)
# Ensure my.cnf has required settings
[mysqld]
server-id=1                          # unique per node: 1, 2, 3
gtid_mode=ON
enforce_gtid_consistency=ON
binlog_checksum=NONE
binlog_transaction_dependency_tracking=WRITESET
transaction_write_set_extraction=XXHASH64
loose-group_replication_start_on_boot=OFF
plugin_load_add='group_replication.so'
plugin_load_add='mysql_clone.so'
report_host='mysql-node-1'           # unique per node

# Step 2: Use MySQL Shell to configure and create the cluster
mysqlsh -- dba configure-instance root@mysql-node-1:3306 --clusterAdmin=gradmin --clusterAdminPassword='SecurePass123!'
mysqlsh -- dba configure-instance root@mysql-node-2:3306 --clusterAdmin=gradmin --clusterAdminPassword='SecurePass123!'
mysqlsh -- dba configure-instance root@mysql-node-3:3306 --clusterAdmin=gradmin --clusterAdminPassword='SecurePass123!'

# Step 3: Connect to the first node and create the cluster
mysqlsh gradmin@mysql-node-1:3306
# Inside MySQL Shell:
var cluster = dba.createCluster('productionCluster', {
    memberWeight: 90,
    exitStateAction: 'ABORT_SERVER',
    consistency: 'BEFORE_ON_PRIMARY_FAILOVER',
    expelTimeout: 10
})

# Step 4: Add remaining nodes
cluster.addInstance('gradmin@mysql-node-2:3306', {recoveryMethod: 'clone'})
cluster.addInstance('gradmin@mysql-node-3:3306', {recoveryMethod: 'clone'})

# Step 5: Verify cluster status
cluster.status()
recoveryMethod: 'clone'選項使用 MySQL 克隆外掛執行從主成員到加入成員的完整資料複製,這比從大型資料集的二進位制日誌進行增量恢復要快得多。
MySQL 路由器配置
MySQL 路由器針對叢集進行引導並自動生成其配置檔案。
# Bootstrap MySQL Router against the cluster
mysqlrouter --bootstrap gradmin@mysql-node-1:3306 \
  --directory /opt/mysqlrouter \
  --conf-use-sockets \
  --user=mysqlrouter \
  --name='production-router'

# Start MySQL Router
/opt/mysqlrouter/start.sh

# Default ports after bootstrap:
# 6446 — R/W (routes to primary)
# 6447 — R/O (round-robin across secondaries)
# 6448 — R/W (X Protocol)
# 6449 — R/O (X Protocol)
應用程式連線到路由器的 R/W 埠進行寫入,連線到 R/O 埠進行讀取副本。當主節點發生故障時,路由器會檢測到拓撲變化並在幾秒鐘內重新路由。
多區域 MySQL 部署
對於跨地域的災難恢復和低延遲讀取,MySQL 可以跨多個區域部署。 InnoDB ClusterSet 擴充套件了 InnoDB Cluster,支援主叢集與不同區域的一個或多個副本叢集之間的非同步複製。
InnoDB ClusterSet 與一個處理所有寫入的主叢集和一個或多個非同步接收更改的副本叢集一起執行。在災難場景中,可以透過 MySQL Shell 將副本叢集提升為主叢集。
# Create a ClusterSet from an existing InnoDB Cluster
mysqlsh gradmin@mysql-node-1:3306
var cluster = dba.getCluster()
var cs = cluster.createClusterSet('globalSet')

# Create a replica cluster in eu-west region
cs.createReplicaCluster('gradmin@mysql-eu-node-1:3306', 'euWestCluster', {
    recoveryMethod: 'clone'
})
var euCluster = cs.getCluster('euWestCluster')
euCluster.addInstance('gradmin@mysql-eu-node-2:3306', {recoveryMethod: 'clone'})
euCluster.addInstance('gradmin@mysql-eu-node-3:3306', {recoveryMethod: 'clone'})

# Emergency failover (when primary cluster is unreachable)
cs.forcePrimaryCluster('euWestCluster')
MySQL — 操作模式
在 Kubernetes 上執行 MySQL 需要解決一些不適用於無狀態工作負載的挑戰:穩定的網路身份、持久儲存、有序啟動和關閉以及叢集感知的執行狀況檢查。 Kubernetes 操作員將特定於域的操作知識編碼到控制器中,該控制器監視自定義資源並將 MySQL 的實際狀態與 YAML 中宣告的所需狀態進行協調。
MySQL 用於 Kubernetes 的操作器 (Oracle)
適用於 Kubernetes 的 Oracle MySQL Operator 在 Kubernetes 上本地部署和管理 InnoDB Cluster 例項。它為 MySQL 伺服器 Pod 建立 StatefulSet、為 MySQL 路由器建立部署,並處理自動故障轉移、擴充套件、備份和配置更改。
# Install the MySQL Operator via Helm
helm repo add mysql-operator https://mysql.github.io/mysql-operator/
helm repo update

helm install mysql-operator mysql-operator/mysql-operator \
  --namespace mysql-operator \
  --create-namespace \
  --set image.pullPolicy=IfNotPresent
操作員執行後,透過建立自定義資源來部署 InnoDB 叢集。
apiVersion: v1
kind: Secret
metadata:
  name: mysql-root-credentials
  namespace: production
stringData:
  rootUser: root
  rootHost: '%'
  rootPassword: 'ProductionSecurePass123!'
---
apiVersion: mysql.oracle.com/v2
kind: InnoDBCluster
metadata:
  name: production-mysql
  namespace: production
spec:
  secretName: mysql-root-credentials
  instances: 3
  tlsUseSelfSigned: true
  router:
    instances: 2
  datadirVolumeClaimTemplate:
    accessModes:
      - ReadWriteOnce
    resources:
      requests:
        storage: 100Gi
    storageClassName: gp3-encrypted
  mycnf: |
    [mysqld]
    innodb_buffer_pool_size=4G
    innodb_log_file_size=1G
    innodb_flush_log_at_trx_commit=1
    sync_binlog=1
    max_connections=500
    innodb_io_capacity=2000
    innodb_io_capacity_max=4000
    innodb_read_io_threads=8
    innodb_write_io_threads=8
    performance_schema=ON
    slow_query_log=ON
    long_query_time=1
  podSpec:
    containers:
      - name: mysql
        resources:
          requests:
            cpu: "2"
            memory: 8Gi
          limits:
            cpu: "4"
            memory: 16Gi
    affinity:
      podAntiAffinity:
        requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
                - key: component
                  operator: In
                  values: [mysqld]
            topologyKey: topology.kubernetes.io/zone
Pod 反關聯性規則可確保 MySQL Pod 分佈在可用區域中,從而提供區域級容錯。mycnf模組允許您直接透過 CR 注入經過生產調整的 MySQL 配置。
適用於 MySQL (PXC) 的 Percona 操作器
Percona Operator for MySQL 部署 Percona XtraDB Cluster (PXC),這是一種基於 Galera 的多主同步複製解決方案。 PXC 與 InnoDB Cluster 的不同之處在於,每個節點都可以接受寫入(真正的多主),並且使用 wsrep API 在認證級別同步複製。
# Install Percona Operator
helm repo add percona https://percona.github.io/percona-helm-charts/
helm repo update

helm install pxc-operator percona/pxc-operator \
  --namespace pxc \
  --create-namespace
# Percona XtraDB Cluster Custom Resource
apiVersion: pxc.percona.com/v1
kind: PerconaXtraDBCluster
metadata:
  name: production-pxc
  namespace: pxc
spec:
  crVersion: '1.14.0'
  secretsName: pxc-secrets
  pxc:
    size: 3
    image: percona/percona-xtradb-cluster:8.0.35
    resources:
      requests:
        memory: 8Gi
        cpu: "2"
      limits:
        memory: 16Gi
        cpu: "4"
    volumeSpec:
      persistentVolumeClaim:
        storageClassName: gp3-encrypted
        accessModes: [ReadWriteOnce]
        resources:
          requests:
            storage: 200Gi
    affinity:
      antiAffinityTopologyKey: topology.kubernetes.io/zone
    configuration: |
      [mysqld]
      innodb_buffer_pool_size=4G
      innodb_flush_log_at_trx_commit=1
      wsrep_provider_options="gcache.size=2G; gcs.fc_limit=256"
      wsrep_slave_threads=8
      wsrep_certify_nonPK=1
      wsrep_trx_fragment_size=10M
      max_connections=500
  haproxy:
    enabled: true
    size: 3
    image: percona/haproxy:2.8.5
    resources:
      requests:
        memory: 1Gi
        cpu: 500m
  proxysql:
    enabled: false
  backup:
    image: percona/percona-xtradb-cluster-operator:1.14.0-pxc8.0-backup-pxb8.0.35
    storages:
      s3-backup:
        type: s3
        verifyTLS: true
        s3:
          bucket: production-mysql-backups
          region: us-east-1
          credentialsSecret: aws-s3-credentials
    schedule:
      - name: daily-full
        schedule: "0 3 * * *"
        keep: 7
        storageName: s3-backup
      - name: hourly-incremental
        schedule: "0 * * * *"
        keep: 24
        storageName: s3-backup
Percona Operator 處理到 S3 的自動備份、時間點恢復、滾動升級以及用於連線路由的 ProxySQL 或 HAProxy。 PXC 中基於 Galera 的複製提供真正的同步多主寫入 - 每個提交的事務都保證存在於所有節點上。
連線路由:MySQL 路由器與 ProxySQL
MySQL路由器和ProxySQL都用作資料庫代理,但它們有不同的優勢。
MySQL 路由器專為 InnoDB 叢集而構建。它讀取叢集後設資料,跟蹤拓撲變化,並將連線路由到正確的主節點或輔助節點。其配置極簡,並且與 MySQL 生態系統無縫整合。缺點是查詢級別路由有限——它在連線級別執行,而不是查詢級別。
ProxySQL是一款通用 MySQL 代理,具有高階功能:查詢級讀/寫分離、查詢快取、連線複用、查詢重寫和複雜的路由規則。它在需要對查詢分佈方式進行細粒度控制的環境中表現出色。
# ProxySQL configuration for read/write splitting
# proxysql.cnf

mysql_servers:
(
    { hostgroup_id=10, hostname="mysql-primary", port=3306, max_connections=200, weight=1000 },
    { hostgroup_id=20, hostname="mysql-secondary-1", port=3306, max_connections=200, weight=500 },
    { hostgroup_id=20, hostname="mysql-secondary-2", port=3306, max_connections=200, weight=500 }
)

mysql_query_rules:
(
    { rule_id=1, active=1, match_digest="^SELECT .* FOR UPDATE$", destination_hostgroup=10, apply=1 },
    { rule_id=2, active=1, match_digest="^SELECT", destination_hostgroup=20, apply=1 },
    { rule_id=3, active=1, match_digest=".*", destination_hostgroup=10, apply=1 }
)

mysql_replication_hostgroups:
(
    { writer_hostgroup=10, reader_hostgroup=20, comment="InnoDB Cluster" }
)
在 Kubernetes 環境中,ProxySQL 可以作為應用程式 Pod 中的邊車容器執行,也可以作為專用部署執行。將其作為 sidecar 執行可以消除網路躍點,但會增加 pod 資源使用率;專用部署更易於大規模管理。
雲提供商比較:託管與自管理
AWS:RDS 多可用區與 Aurora 與 EKS
上的自我管理Amazon RDS 多可用區可在不同可用區的主例項和備用例項之間提供自動故障轉移。故障轉移通常需要 60-120 秒。它使用同步物理複製到備用資料庫。可以新增只讀副本以進行讀取擴充套件,但它們使用非同步複製。 RDS 處理備份、修補和監控,但限制您對 MySQL 配置和版本選擇的控制。
Amazon Aurora MySQL是 MySQL 儲存引擎的雲原生重寫。它將計算與儲存分開——儲存層是一個分散式容錯系統,可以跨三個可用區以六種方式複製資料。 Aurora 提供不到 10 秒的故障轉移、最多 15 個只讀副本(複製延遲最小)以及自動儲存擴充套件至 128 TiB。 Aurora Serverless v2 為不可預測的工作負載新增了自動計算擴充套件。代價是成本(Aurora 比 RDS 貴 20-40%)以及與某些 MySQL 功能的相容性降低。
在 EKS上進行自我管理,讓您可以完全控制 MySQL 版本、配置和複製拓撲。當您需要託管服務中不可用的特定 MySQL 功能、需要多雲可移植性或大規模成本最佳化證明運營開銷合理時,請使用此功能。
# EKS StorageClass for MySQL with gp3 volumes
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: gp3-encrypted
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  iops: "6000"
  throughput: "250"
  encrypted: "true"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
reclaimPolicy: Retain
allowVolumeExpansion: true
Azure:AKS
上的靈活伺服器與自我管理伺服器Azure 用於 MySQL 靈活伺服器的資料庫提供帶自動故障轉移功能的區域冗餘 HA、同區域只讀副本以及高達 16 TiB 的儲存。它支援可配置的維護視窗、停止/啟動例項的能力(有助於節省開發/測試成本)以及與 Azure Private Link 整合以實現網路隔離。關鍵業務層透過本地 SSD 儲存提供最佳效能。
在 AKS 上進行自我管理將 Azure 託管磁碟(建議用於資料庫工作負載的高階 SSD v2)與 MySQL Operator 或 Percona Operator 結合使用。 AKS 提供可用性區域支援和用於容器級 VNET 整合的 Azure CNI。
# AKS StorageClass for MySQL
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: premium-ssd-zrs
provisioner: disk.csi.azure.com
parameters:
  skuName: Premium_ZRS
  cachingMode: None
  DiskIOPSReadWrite: "5000"
  DiskMBpsReadWrite: "200"
volumeBindingMode: WaitForFirstConsumer
reclaimPolicy: Retain
allowVolumeExpansion: true
Google Cloud:Cloud SQL 與 GKE
上的自我管理適用於 MySQL的 Google Cloud SQL 提供區域例項,具有跨區域自動故障轉移、只讀副本(包括跨區域)以及具有時間點恢復功能的自動備份。 Cloud SQL 透過整合到 Google 的 IAM、VPC 和監控生態系統,提供最高階別的管理便利性。 Enterprise Plus 層增加了近乎零停機的維護和資料快取,以提高讀取效能。
在 GKE 上進行自我管理使用持久磁碟 SSD 或 Hyperdisk 進行儲存。 GKE Autopilot 簡化了節點管理,並且可以以最小的運營開銷執行 MySQL Operator。
# GKE StorageClass for MySQL
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ssd-regional
provisioner: pd.csi.storage.gke.io
parameters:
  type: pd-ssd
  replication-type: regional-pd
volumeBindingMode: WaitForFirstConsumer
reclaimPolicy: Retain
allowVolumeExpansion: true
裸機:k3s + Rancher + Longhorn
並非所有工作負載都屬於公共雲。為了滿足資料主權、合規性、成本最佳化或延遲要求,執行帶有 Rancher 管理和 Longhorn 儲存的 k3s 的裸機 Kubernetes 叢集為 MySQL HA 提供了生產級平臺。
k3s 安裝和配置
k3s 是一款輕量級、經過認證的 Kubernetes 發行版,非常適合邊緣和裸機。它將所有控制平面元件捆綁到一個二進位制檔案中,並使用 SQLite 或嵌入式 etcd 進行狀態儲存。
# Install k3s server (first control-plane node)
curl -sfL https://get.k3s.io | sh -s - server \
  --cluster-init \
  --tls-san 10.10.0.10 \
  --disable traefik \
  --disable servicelb \
  --write-kubeconfig-mode 644

# Join additional server nodes
curl -sfL https://get.k3s.io | K3S_TOKEN=$(cat /var/lib/rancher/k3s/server/node-token) sh -s - server \
  --server https://10.10.0.10:6443 \
  --tls-san 10.10.0.10

# Join worker nodes
curl -sfL https://get.k3s.io | K3S_URL=https://10.10.0.10:6443 \
  K3S_TOKEN=$(cat /var/lib/rancher/k3s/server/node-token) sh -s -
適用於 MySQL 的 Longhorn 儲存
Longhorn是專為Kubernetes構建的雲原生分散式塊儲存系統。 它跨節點複製資料,提供快照和備份,並與 Kubernetes CSI 驅動程式本地整合。對於 MySQL,Longhorn 提供了雲提供商透過其託管磁碟產品處理的持久複製儲存層。
# Install Longhorn
helm repo add longhorn https://charts.longhorn.io
helm repo update

helm install longhorn longhorn/longhorn \
  --namespace longhorn-system \
  --create-namespace \
  --set defaultSettings.defaultReplicaCount=3 \
  --set defaultSettings.storageMinimalAvailablePercentage=15 \
  --set defaultSettings.guaranteedInstanceManagerCPU=12

# StorageClass for MySQL on Longhorn
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: longhorn-mysql
provisioner: driver.longhorn.io
parameters:
  numberOfReplicas: "3"
  staleReplicaTimeout: "2880"
  dataLocality: best-effort
  diskSelector: ssd
  fsType: ext4
reclaimPolicy: Retain
volumeBindingMode: Immediate
allowVolumeExpansion: true
MetalLB 用於負載平衡
在裸機上,沒有云負載均衡器。 MetalLB 透過使用第 2 層 (ARP) 或 BGP 模式將外部 IP 地址分配給 LoadBalancer 型別的 Kubernetes 服務來填補這一空白。
# MetalLB IP Address Pool and L2 Advertisement
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: mysql-pool
  namespace: metallb-system
spec:
  addresses:
    - 10.10.0.100-10.10.0.110
---
apiVersion: metallb.io/v1beta1
kind: L2Advertisement
metadata:
  name: mysql-l2
  namespace: metallb-system
spec:
  ipAddressPools:
    - mysql-pool
備份和恢復策略
高可用性叢集可防止節點故障。備份可以防止資料損壞、意外刪除、應用程式錯誤以及整個叢集丟失的災難恢復情況。你兩者都需要。
使用 mysqldump 進行邏輯備份
mysqldump生成行動式且可讀的 SQL 格式備份。對於 50 GB 以下的資料庫,這是最簡單的選擇。對於較大的資料集,鎖定和匯出時間使其在工作時間用於生產使用是不切實際的。
# Full logical backup with consistent snapshot
mysqldump --all-databases \
  --single-transaction \
  --routines \
  --triggers \
  --events \
  --set-gtid-purged=ON \
  --result-file=/backups/full-$(date +%Y%m%d-%H%M%S).sql

# Compressed backup piped to S3
mysqldump --all-databases --single-transaction | \
  gzip | aws s3 cp - s3://mysql-backups/full-$(date +%Y%m%d).sql.gz
使用 Percona XtraBackup 進行物理備份
Percona XtraBackup 對 InnoDB 資料執行熱、非阻塞物理備份。它在跟蹤重做日誌的同時複製 InnoDB 資料檔案,然後在準備階段應用重做日誌以生成一致的備份。對於大型資料集,它比 mysqldump 快得多,並且支援增量備份。
# Full physical backup
xtrabackup --backup \
  --target-dir=/backups/full \
  --user=backup_user \
  --password=SecureBackupPass \
  --parallel=4 \
  --compress \
  --compress-threads=4

# Incremental backup based on previous full
xtrabackup --backup \
  --target-dir=/backups/incr-$(date +%H) \
  --incremental-basedir=/backups/full \
  --user=backup_user \
  --password=SecureBackupPass

# Prepare (apply redo log) and restore
xtrabackup --prepare --target-dir=/backups/full
xtrabackup --prepare --target-dir=/backups/full \
  --incremental-dir=/backups/incr-01

# Copy back to data directory
xtrabackup --copy-back --target-dir=/backups/full --datadir=/var/lib/mysql
chown -R mysql:mysql /var/lib/mysql
二進位制日誌 (binlog) 時間點恢復
二進位制日誌記錄每個資料修改事務。與完整備份相結合,它們可以實現時間點恢復 (PITR) — 恢復到任何特定時刻,而不僅僅是上次備份的時間。
# Enable binlog retention (my.cnf)
[mysqld]
log_bin=mysql-bin
binlog_expire_logs_seconds=604800   # 7 days
binlog_format=ROW
gtid_mode=ON
enforce_gtid_consistency=ON

# Restore from backup then replay binlogs to a specific point
mysqlbinlog --start-datetime="2026-04-12 08:00:00" \
  --stop-datetime="2026-04-12 09:30:00" \
  mysql-bin.000042 mysql-bin.000043 | mysql -u root -p

# Or replay to a specific GTID position
mysqlbinlog --include-gtids="3c2d4f9e-d17e-ec59-9029-6aafa8accef8:1-5000" \
  mysql-bin.000042 | mysql -u root -p
Kubernetes 備份 CronJob
在 Kubernetes 中,備份應作為 CronJobs 而不是臨時命令執行。這確保了備份是自動化的、受監控的,並且在失敗時可以收到警報。
apiVersion: batch/v1
kind: CronJob
metadata:
  name: mysql-backup
  namespace: production
spec:
  schedule: "0 2 * * *"
  concurrencyPolicy: Forbid
  successfulJobsHistoryLimit: 7
  failedJobsHistoryLimit: 3
  jobTemplate:
    spec:
      activeDeadlineSeconds: 7200
      template:
        spec:
          restartPolicy: OnFailure
          containers:
            - name: backup
              image: percona/percona-xtrabackup:8.0.35
              command:
                - /bin/sh
                - -c
                - |
                  BACKUP_DIR=/backups/$(date +%Y%m%d-%H%M%S)
                  mkdir -p $BACKUP_DIR
                  xtrabackup --backup \
                    --host=production-mysql.production.svc \
                    --user=backup_user \
                    --password=$BACKUP_PASSWORD \
                    --target-dir=$BACKUP_DIR \
                    --parallel=4 \
                    --compress
                  xtrabackup --prepare --target-dir=$BACKUP_DIR
                  # Upload to S3
                  aws s3 sync $BACKUP_DIR s3://mysql-backups/$(date +%Y%m%d)/
                  # Cleanup local
                  rm -rf $BACKUP_DIR
              env:
                - name: BACKUP_PASSWORD
                  valueFrom:
                    secretKeyRef:
                      name: mysql-backup-credentials
                      key: password
              volumeMounts:
                - name: backup-scratch
                  mountPath: /backups
              resources:
                requests:
                  cpu: "1"
                  memory: 2Gi
                limits:
                  cpu: "2"
                  memory: 4Gi
          volumes:
            - name: backup-scratch
              emptyDir:
                sizeLimit: 100Gi
透過 Percona 監控和管理 (PMM) 進行監控
Percona 監控和管理 (PMM) 是一個專為資料庫可觀察性而構建的開源監控平臺。雖然 Prometheus 和 Grafana 提供常規 Kubernetes 監控,但 PMM 增加了 MySQL 特定的見解:識別慢速查詢的查詢分析 (QAN)、複製滯後儀表板、InnoDB 緩衝池命中率、表鎖爭用等。
# Deploy PMM Server on Kubernetes
apiVersion: apps/v1
kind: Deployment
metadata:
  name: pmm-server
  namespace: monitoring
spec:
  replicas: 1
  selector:
    matchLabels:
      app: pmm-server
  template:
    metadata:
      labels:
        app: pmm-server
    spec:
      containers:
        - name: pmm-server
          image: percona/pmm-server:2
          ports:
            - containerPort: 443
          env:
            - name: DISABLE_TELEMETRY
              value: "1"
          volumeMounts:
            - name: pmm-data
              mountPath: /srv
          resources:
            requests:
              cpu: "1"
              memory: 4Gi
            limits:
              cpu: "2"
              memory: 8Gi
      volumes:
        - name: pmm-data
          persistentVolumeClaim:
            claimName: pmm-data-pvc
---
apiVersion: v1
kind: Service
metadata:
  name: pmm-server
  namespace: monitoring
spec:
  type: ClusterIP
  selector:
    app: pmm-server
  ports:
    - port: 443
      targetPort: 443
# Register MySQL instances with PMM Client (run on each MySQL pod or sidecar)
pmm-admin config --server-url=https://admin:password@pmm-server.monitoring:443 --server-insecure-tls
pmm-admin add mysql \
  --username=pmm_monitor \
  --password=MonitorPass123 \
  --host=127.0.0.1 \
  --port=3306 \
  --query-source=perfschema \
  --service-name=mysql-node-1
PMM 的查詢分析在生產中特別有價值。它捕獲在伺服器上執行的每個查詢(透過效能架構或慢速查詢日誌),透過指紋聚合它們,並顯示平均延遲、檢查的行與傳送的行和鎖定時間等指標。這是您識別降低應用程式效能的查詢的方法。
生產配置調整
預設 MySQL 配置針對小型通用工作負載進行了調整。具有專用資料庫伺服器的生產環境需要顯著不同的設定。以下是關鍵引數以及如何調整它們的大小。
InnoDB 緩衝池
InnoDB 緩衝池是 MySQL 在記憶體中快取表和索引資料的地方。它是最有影響力的配置引數。對於專用 MySQL 伺服器,將其設定為可用 RAM 的 70–80%。
[mysqld]
# Memory: 16Gi container limit -> allocate ~12Gi to buffer pool
innodb_buffer_pool_size = 12G
innodb_buffer_pool_instances = 8          # 1 per GB (up to 64)
innodb_buffer_pool_chunk_size = 1536M     # pool_size / instances
重做日誌配置
重做日誌在將寫入重新整理到資料檔案之前吸收寫入。較大的重做日誌會降低檢查點重新整理的頻率並提高寫入吞吐量。 MySQL 8.0.30+ 使用innodb_redo_log_capacity而不是舊版innodb_log_file_size。
[mysqld]
# MySQL 8.0.30+
innodb_redo_log_capacity = 4G

# MySQL 8.0.29 and earlier
# innodb_log_file_size = 2G
# innodb_log_files_in_group = 2
耐用性與效能的權衡
innodb_flush_log_at_trx_commit和sync_binlog的組合決定了您的耐用性保證。
- 最大耐用性(建議量產):
innodb_flush_log_at_trx_commit=1+sync_binlog=1。每個事務在被確認之前都會重新整理到磁碟上的重做日誌和二進位制日誌。崩潰時零資料丟失。 - 平衡:
innodb_flush_log_at_trx_commit=2+sync_binlog=1。重做日誌每次提交都會寫入作業系統快取,但每秒僅重新整理到磁碟一次。作業系統崩潰時最多可能會丟失 1 秒的事務(MySQL 崩潰仍然是安全的)。 - 最大效能(不建議量產):
innodb_flush_log_at_trx_commit=0+sync_binlog=0。寫入會定期進行批次和重新整理。任何崩潰都會有丟失最多 1 秒交易的風險。
[mysqld]
# Production durability settings
innodb_flush_log_at_trx_commit = 1
sync_binlog = 1
innodb_doublewrite = ON
innodb_checksum_algorithm = crc32
I/O 配置
[mysqld]
# SSD-optimised I/O settings
innodb_io_capacity = 4000
innodb_io_capacity_max = 8000
innodb_read_io_threads = 8
innodb_write_io_threads = 8
innodb_flush_method = O_DIRECT
innodb_file_per_table = ON
innodb_open_files = 10000
連線和執行緒管理
[mysqld]
max_connections = 500
max_connect_errors = 1000000
thread_cache_size = 64
table_open_cache = 4096
table_open_cache_instances = 16
back_log = 1500

# Thread pool (MySQL Enterprise or Percona)
thread_pool_size = 16
thread_pool_max_threads = 1000
臨時表和排序緩衝區
[mysqld]
tmp_table_size = 64M
max_heap_table_size = 64M
sort_buffer_size = 4M
join_buffer_size = 4M
read_rnd_buffer_size = 2M
完整生產配置模板
[mysqld]
# Identity
server-id = 1
report_host = mysql-node-1

# GTID Replication
gtid_mode = ON
enforce_gtid_consistency = ON
binlog_format = ROW
log_bin = mysql-bin
binlog_expire_logs_seconds = 604800
log_slave_updates = ON
relay_log_recovery = ON

# InnoDB Engine
innodb_buffer_pool_size = 12G
innodb_buffer_pool_instances = 8
innodb_redo_log_capacity = 4G
innodb_flush_log_at_trx_commit = 1
sync_binlog = 1
innodb_doublewrite = ON
innodb_flush_method = O_DIRECT
innodb_io_capacity = 4000
innodb_io_capacity_max = 8000
innodb_read_io_threads = 8
innodb_write_io_threads = 8
innodb_file_per_table = ON
innodb_open_files = 10000
innodb_adaptive_hash_index = ON
innodb_change_buffering = all

# Connections
max_connections = 500
max_connect_errors = 1000000
thread_cache_size = 64
table_open_cache = 4096
table_open_cache_instances = 16
back_log = 1500

# Temp / Sort
tmp_table_size = 64M
max_heap_table_size = 64M
sort_buffer_size = 4M
join_buffer_size = 4M

# Monitoring
performance_schema = ON
slow_query_log = ON
long_query_time = 1
log_queries_not_using_indexes = ON
log_throttle_queries_not_using_indexes = 60

# Security
local_infile = OFF
skip_name_resolve = ON
default_authentication_plugin = caching_sha2_password

# Group Replication (InnoDB Cluster)
plugin_load_add = 'group_replication.so'
plugin_load_add = 'mysql_clone.so'
loose-group_replication_start_on_boot = OFF
loose-group_replication_bootstrap_group = OFF
loose-group_replication_recovery_use_ssl = ON
loose-group_replication_ssl_mode = REQUIRED
故障轉移測試和混沌工程
從未在故障情況下進行過測試的高可用性系統並不是真正的高可用性 - 這只是一個假設。故障轉移測試必須成為您常規操作節奏的一部分,而不是您在實際事件期間發現有效(或無效)的東西。
受控故障轉移測試
# Test 1: Graceful primary failover (InnoDB Cluster)
mysqlsh gradmin@mysql-node-1:3306
var cluster = dba.getCluster()
cluster.setPrimaryInstance('gradmin@mysql-node-2:3306')
# Verify: cluster.status() should show node-2 as PRIMARY

# Test 2: Simulate primary crash
# On the primary node:
kill -9 $(pidof mysqld)
# Monitor: watch the cluster elect a new primary
# Verify: applications reconnect via MySQL Router within seconds

# Test 3: Network partition simulation
# On the primary node, block Group Replication port:
iptables -A INPUT -p tcp --dport 33061 -j DROP
iptables -A OUTPUT -p tcp --dport 33061 -j DROP
# The isolated node should be expelled; cluster continues with remaining members
# Cleanup:
iptables -D INPUT -p tcp --dport 33061 -j DROP
iptables -D OUTPUT -p tcp --dport 33061 -j DROP

# Test 4: Kubernetes pod deletion
kubectl delete pod mysql-0 -n production --grace-period=0 --force
# The StatefulSet controller recreates the pod
# The operator rejoins it to the cluster
採用 Litmus 或混沌網格的混沌工程
結構化混沌工程工具系統地注入故障並測量爆炸半徑。 Chaos Mesh 是 CNCF 專案,與 Kubernetes 原生整合。
# Chaos Mesh: Kill a MySQL pod randomly
apiVersion: chaos-mesh.org/v1alpha1
kind: PodChaos
metadata:
  name: mysql-pod-kill
  namespace: production
spec:
  action: pod-kill
  mode: one
  selector:
    namespaces:
      - production
    labelSelectors:
      app.kubernetes.io/component: mysqld
  scheduler:
    cron: "0 */4 * * *"
---
# Chaos Mesh: Network delay between MySQL pods
apiVersion: chaos-mesh.org/v1alpha1
kind: NetworkChaos
metadata:
  name: mysql-network-delay
  namespace: production
spec:
  action: delay
  mode: one
  selector:
    namespaces:
      - production
    labelSelectors:
      app.kubernetes.io/component: mysqld
  delay:
    latency: "200ms"
    jitter: "50ms"
  duration: "5m"
  scheduler:
    cron: "30 */6 * * *"
---
# Chaos Mesh: Disk I/O stress
apiVersion: chaos-mesh.org/v1alpha1
kind: IOChaos
metadata:
  name: mysql-io-latency
  namespace: production
spec:
  action: latency
  mode: one
  selector:
    namespaces:
      - production
    labelSelectors:
      app.kubernetes.io/component: mysqld
  volumePath: /var/lib/mysql
  path: '*'
  delay: '100ms'
  percent: 50
  duration: '5m'
在故障轉移測試期間測量什麼
- 恢復時間目標 (RTO)— 從故障檢測到服務恢復需要多長時間? InnoDB Cluster 通常可以達到 5-30 秒。 Percona XtraDB Cluster 可以更快,因為沒有選舉(所有節點都是可寫的)。
- 恢復點目標 (RPO)— 故障轉移期間丟失了多少資料?使用同步複製(單主模式下的組複製,PXC),已提交事務的 RPO 為零。對於非同步複製(ClusterSet 跨區域),RPO 等於複製滯後。
- 應用程式錯誤率— 在故障轉移視窗期間有多少應用程式請求失敗?這不僅測試資料庫故障轉移,還測試應用程式的連線重試邏輯和 MySQL 路由器的重新路由速度。
- 連線耗盡時間— 與舊主裝置的現有連線需要多長時間才能耗盡並重新連線到新主裝置?
執行手冊:主節點故障檢查表
- 驗證叢集已選擇新的主叢集:
cluster.status() - 確認 MySQL 路由器正在路由到新的主路由器:檢查路由器日誌和連線計數
- 監控剩餘輔助節點上的複製延遲:
SELECT * FROM performance_schema.replication_group_member_stats - 如果故障節點可以恢復,則重新加入它:
cluster.rejoinInstance('gradmin@failed-node:3306') - 如果故障節點無法恢復,請將其刪除並新增新節點:
cluster.removeInstance('gradmin@failed-node:3306', {force: true}) - 驗證叢集健康狀況:所有成員均線上,無複製錯誤,備份計劃完好無損
- 更新您的容量計劃:使用 2 個節點執行意味著您的容錯能力為零,直到第三個節點恢復為止
安全強化
生產 MySQL 部署必須解決基本身份驗證之外的多個安全問題。
傳輸中和靜態加密
[mysqld]
# TLS for client connections
ssl_ca = /etc/mysql/certs/ca.pem
ssl_cert = /etc/mysql/certs/server-cert.pem
ssl_key = /etc/mysql/certs/server-key.pem
require_secure_transport = ON
tls_version = TLSv1.3

# Encryption at rest (InnoDB tablespace encryption)
early-plugin-load = keyring_file.so
keyring_file_data = /var/lib/mysql-keyring/keyring
innodb_undo_log_encrypt = ON
innodb_redo_log_encrypt = ON
default_table_encryption = ON
Kubernetes 的秘密和密封的秘密
# Never store database credentials in plain YAML
# Use Sealed Secrets or an external secret manager
apiVersion: bitnami.com/v1alpha1
kind: SealedSecret
metadata:
  name: mysql-root-credentials
  namespace: production
spec:
  encryptedData:
    rootUser: AgBy3i4OJSWK+PiTy...
    rootPassword: AgCtr7pJ2XQWK+Pi...
  template:
    metadata:
      name: mysql-root-credentials
      namespace: production
    type: Opaque
審計記錄
[mysqld]
# MySQL Enterprise Audit (or Percona Audit Log plugin)
plugin-load-add = audit_log.so
audit_log_format = JSON
audit_log_policy = LOGINS
audit_log_rotate_on_size = 100M
audit_log_rotations = 10
決策矩陣:選擇 MySQL HA 架構
正確的架構取決於您的具體要求。這是一個決策框架。
- 單雲、託管首選項、MySQL 相容— 使用 Aurora (AWS)、靈活伺服器業務關鍵型 (Azure) 或 Cloud SQL Enterprise Plus (GCP)。這些提供了最低的運營開銷。
- 單雲、自我管理、需要完整的 MySQL 控制— 在具有云原生儲存類的 EKS/AKS/GKE 上使用 MySQL Operator 或 Percona Operator。
- 多雲或混合雲— 將 Percona Operator 與 PXC 結合使用,或將 MySQL Operator 與 InnoDB Cluster 結合使用。 Kubernetes 抽象層使您的 MySQL 部署可跨雲移植。
- 裸機或邊緣— 將 k3s 與 Rancher、Longhorn 儲存、MetalLB 以及 MySQL Operator 或 Percona Operator 結合使用。
- 最大寫入吞吐量,需要多主— 將 Percona XtraDB 叢集 (Galera) 與 Percona Operator 結合使用。所有節點都接受具有同步認證的寫入。
- 具有災難恢復功能的全球分佈— 使用 InnoDB ClusterSet 進行區域之間的非同步複製。接受非同步複製的 RPO 與本地寫入的延遲優勢之間的權衡。
生產 MySQL HA
操作清單在宣告您的 MySQL HA 部署已投入生產之前,請驗證此清單上的每一項。
- 叢集執行狀況— 所有成員均報告聯機狀態。組複製未顯示任何錯誤。
- 自動備份— 按計劃執行 CronJob 或操作員管理的備份。透過定期恢復測試驗證備份。
- 監控— PMM 或 Prometheus/Grafana 收集 MySQL 指標。針對複製滯後、連線飽和、緩衝池命中率低於 99% 以及磁碟空間配置的警報。
- 故障轉移測試— 在過去 30 天內測試了主要故障轉移。 RTO 和 RPO 已測量且符合 SLA 目標。
- 連線路由— MySQL 路由器或 ProxySQL 執行狀況檢查和負載平衡。 應用程式連線字串指向路由器,而不是單個 MySQL 例項。
- 安全性— 所有連線都需要 TLS。靜態加密已啟用。憑證儲存在秘密管理器中。稽核日誌記錄處於活動狀態。每個應用程式的最低許可權資料庫使用者。
- 資源限制— Kubernetes 資源請求和限制設定適當。 PodDisruptionBudgets 到位。 Pod 反關聯性將 MySQL Pod 跨區域傳播。
- 容量計劃— 監控儲存利用率,並在 70% 和 85% 時發出警報。已測試體積膨脹。記錄垂直和水平縮放程式。
- 執行手冊— 主故障轉移、節點更換、備份恢復、版本升級和緊急只讀模式的記錄程式。
- 混沌測試— 計劃定期進行混沌實驗,以驗證彈性假設。
結論
MySQL 在生產中的高可用性不是單一的技術選擇 - 它是一個跨複製層、編排平臺、儲存子系統、監控堆疊及其周圍操作流程的連鎖決策系統。具有組複製功能的 InnoDB Cluster 提供了基礎的 HA 原語。 Oracle 和 Percona 的 Kubernetes 操作員可自動執行生命週期管理,否則會消耗大量工程時間。為了方便起見,雲管理服務貿易控制。 k3s、Rancher 和 Longhorn 的裸機部署證明您不需要雲提供商來執行生產級 MySQL HA。
最關鍵的一點是,高可用性是整個系統的屬性,而不僅僅是資料庫的屬性。它包括您的應用程式如何處理連線故障和重試,您的代理層如何檢測故障節點並進行路由,您的監控如何在使用者注意到之前發出警報,您的備份策略如何實現從僅 HA 無法處理的場景中恢復,以及您的團隊如何實踐故障轉移程式,以便它們在真實事件的壓力下乾淨地執行。
精心構建,定期測試,並將您的操作手冊視為隨每個事件和每個混亂實驗而演變的動態文件。這就是 MySQL 作為生產中可靠、高度可用的資料平臺的原因。