渦輪增壓LLMs
PagedAttention、vLLM、Self-Debugging、PowerInfer 和 EG-MLA — 如何在不浪費 GPU KV 快取的情況下擴充套件 LLM 代理
 Balinder Walia2026年8月30日1 min read
Workstation關於如何在生產中增強大型語言模型:PagedAttention、vLLM、Self-Debugging、PowerInfer 和 EG-MLA — 以及 GPU 上實際顯示的權衡。深入探討:長文。入門:LLMs 解釋 + Kubernetes。
手錶:LLM 實際上是什麼
上下文,而不是產品演示:大型語言模型簡介 (Andrej Karpathy)。與我們的簡單英語 LLM + Kubernetes 指南配對。
的擴充套件問題LLMs 解鎖了對話式 AI 和生成,然後立即成為服務問題。每個解碼步驟都會將鍵和值附加到 KV 快取中,該快取隨著序列長度和批次大小而增長。簡單的引擎預先保留巨大的連續板。當其他請求等待時,大部分記憶體處於空閒狀態。儘管 GPU 看起來“滿”,但吞吐量卻崩潰了。
PagedAttention:注意
的虛擬記憶體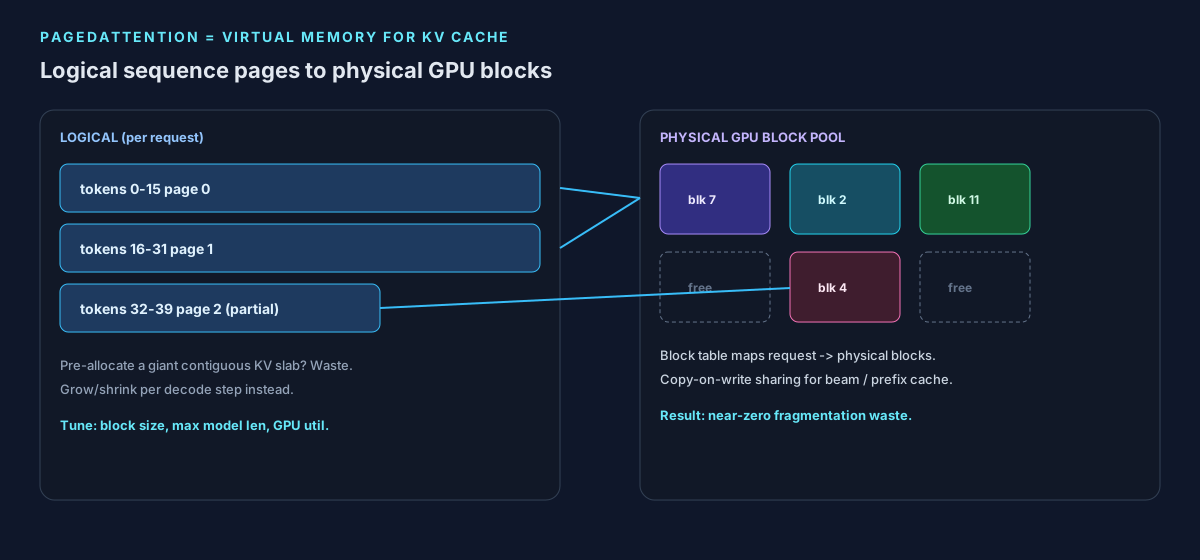
PagedAttention(Kwon 等人,SOSP 2023)將 KV 快取視為作業系統分頁:固定大小的塊、每個請求一個塊表、非連續的物理頁[arXiv:2309.06180]。核心在關注時間收集塊。您仍然必須調整塊大小、最大模型長度和快取層次結構(GPU HBM 與 CPU 解除安裝與字首快取)。太小的塊會增加對映開銷;太大的塊會重新引入廢物。
vLLM:接近零浪費的
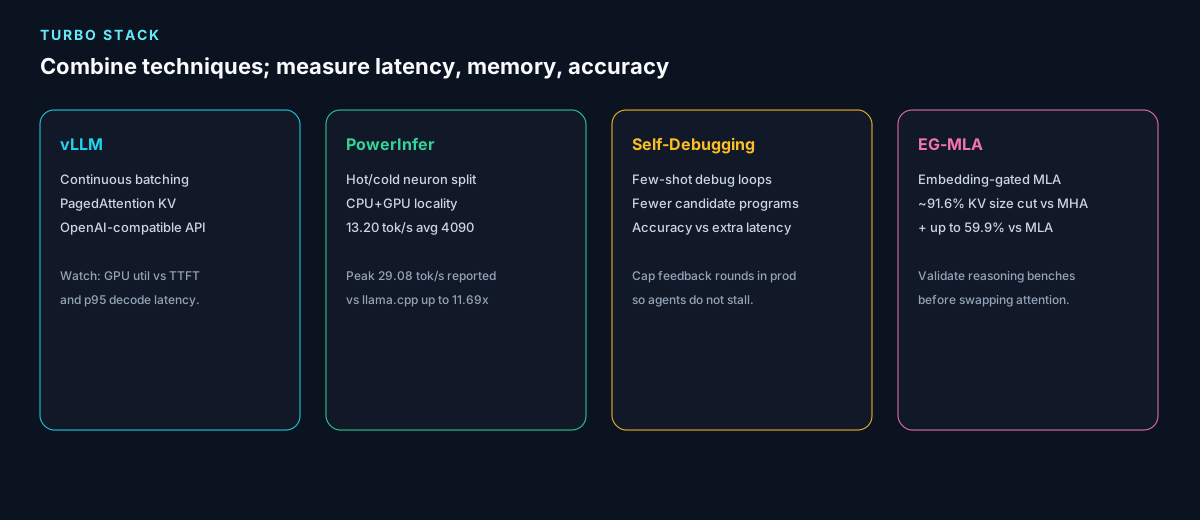
vLLM是圍繞PagedAttention構建的服務系統。它的目標是接近零 KV 浪費、連續配料和相容 OpenAI 的 HTTP 表面。在生產中,請注意三件事:(1)gpu_memory_utilization與 OOM,(2) 首次令牌時間與解碼令牌/秒,(3) 字首/提示快取是否會更改評估集的答案。快取是吞吐量的勝利;它並非沒有正確性和尾部延遲效應。
from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)
這才是真正的vLLM用法。 Hugging Face BERTforward()呼叫是,而不是PagedAttention — 不要將分類器 logits 與分頁 KV 服務混淆。
Self-Debugging:具有延遲預算的質量迴圈
Self-Debugging(Chen 等人)教導模型根據少量軌跡修復自己的預測程式,匹配或擊敗發出 10 倍以上候選的基線 [arXiv:2304.05128]。對於代理商來說,這就是黃金——直到反饋輪累積為止。限制除錯訊息的數量,記錄每一輪,並在預算耗盡時向人類或較小的專業模型關閉失敗。
觀看:服務和推理上下文
關於快速 LLM 服務的上下文討論 — 不是官方的 Workstation 演示。與 vLLM 紙和docs.vllm.ai配對。
PowerInfer:單胖 GPU
上的令牌PowerInfer 分離熱/冷神經元,因此消費者 GPU 和 CPU 可以快速生成令牌。報告資料:13.20 個令牌/秒平均,峰值29.08 個令牌/秒在一臺 NVIDIA RTX 4090 上,11.69x與 llama.cpp 相比,同時保持精度[PowerInfer]。 在艦隊規模上,您仍然需要放置:哪些層保留在 GPU 上,如何跨節點分片,以及提示的位置配置檔案是否與論文的模型匹配。
EG-MLA:在不破壞工作臺的情況下縮小 KV
EG-MLA(嵌入門控多頭潛在注意力)報告超過 91.6% KV 快取減少與多頭注意力相比,降級可忽略不計,與 MLA 相比額外節省(高達 59.9%),並且推理套件得分更高,縮放超過 1B 引數[EG-MLA 論文]。將其視為一種架構選擇,而不是凍結的 vLLM 檢查點上的插入標誌 - 在慶祝記憶體圖之前驗證您的評估工具。
將其放在一起
結合 PagedAttention + vLLM 進行叢集服務,PowerInfer(當盒子是工作站 GPU),Self-Debugging 內部編碼代理具有硬輪限制,以及 EG-MLA(當您控制模型系列時)。分散式服務增加了複雜性:KV 並行性、預填充/解碼分割以及不會影響頁表的自動縮放。措施。然後寫ADR。
讀取下一個
- 長文— 旋鈕、故障模式、Kubernetes 註釋。
- LLMs 解釋 + 在 Kubernetes 上執行您自己的
- Muse Glimmer / 本地代理·企業人工智慧實驗室
由Workstation釋出。