最適合: 大規模訓練或提供服務且採用最新 NVIDIA 系統的 AI 實驗室與企業。
AI 服務
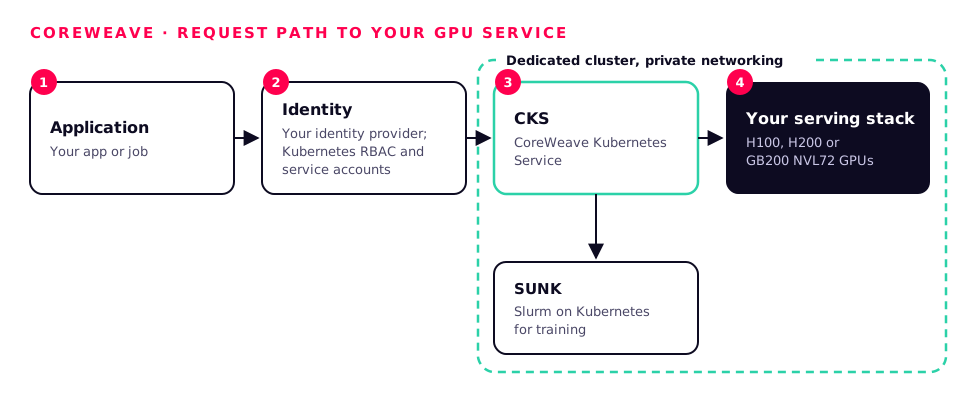
- CoreWeave Kubernetes Service (CKS) 與 SUNK (Slurm on Kubernetes) 用於訓練。
- Weights & Biases 用於實驗追蹤與評估,現已併入 CoreWeave。
GPU 與加速器
- 超大規模的 H100、H200 與 GB200 NVL72 系統,搭配 InfiniBand 網路架構。
代理與身分
- Kubernetes RBAC 與服務帳戶;可自帶身分提供者。
安全與資料
- 專用叢集與私有網路;軟體堆疊由您掌控。
擴展與最佳化
- 每個叢集數千顆 GPU;預留容量可確保訓練執行可預期。
英國與歐盟區域
英國與歐洲資料中心。
注意事項
多半為預留、合約制的容量;相較於超大規模雲端業者,您需要自行管理更多平台層面。
Workstation 如何協助: 我們在 CoreWeave 上建構 Kubernetes、Slurm 與服務堆疊,並為其運行 CI/CD 與可觀測性。
以 Amazon Bedrock 大規模擴展 AI →雲端上適用於 LLM、代理程式與資料的 CI/CD →保護 LLM 與代理程式 API →AI 代理程式 harness →AI 的身分識別與驗證 →
我們合作的其他供應商
標誌為各所有者之商標,僅用於識別各平台,並取自 Wikimedia Commons。圖表由 Workstation 團隊製作。